[英] Telegraphic Transfer Selling Rate TTSとは、円を外貨に替える際に適用される為替レートのことで「電信売相場」と訳される。 金融機関が、投資家へ外貨を販売する際のレートである。
Text-To-Speech
音声合成による,テキストの読み上げ機能のこと。
テキストや文字列をソフトウェアが解析して,その言語で音声出力すること。
Zorin OS と Jetson で使える TTS を試す TTS とは TTS(Text To Speech)は、テキストを音声に変換する仕組み。 LLM の出力を読み上げる用途で使うことが多い。 Linux では複数の TTS があるが、 Jetson と Zorin OS の両方で安定して動くのは Piper。 実行環境 Zorin OS 18.1 Core(VersaPro) Jetson Orin Nano(Jetson Linux) Piper を選んだ理由 Ubuntu 系でそのまま動く CPU / GPU のどちらでも動作 日本語モデルの品質が高い コマンドラインで扱いやすい…
STT→LLM→TTSパイプラインをローカルでどう解決したか、実装系統別の比較表です。 実装系統 STT LLM TTS ローカル完結度 M5Stack公式(AI.AGENT) 非公開(詳細不明) 非公開、EZDATA経由と推測 非公開 クラウド前提、AI.AGENT機能として一体提供。詳細非公開でブラックボックス Note AI_StackChan_Ex(基本形) Google Cloud STT / OpenAI Whisper Docswell ChatGPT(OpenAI API) Docswell OpenAI TTS / VOICEVOX / ElevenLabs / AquesT…
以前、日本語ボイスクローンTTS「Irodori-TTS」をGoogle Colabで触ってみた、という記事を書きました。その後の実験で、手元のUbuntuラップトップのGTX 1070 Mobileで動かそうとしたらGPUの世代の都合で動かせなかったのです。 原因はtorchの対応GPU世代で、Pascal世代(GTX 10x0系)が最新torchのサポートから外れていた、というものでした。 参照記事:Irodori-TTSをGoogle Colabで試す(日本語ボイスクローンTTS) uepon.hatenadiary.com じゃあ、Pascalの次の世代であるTuring、たとえば中古…
📑 RP2350エッジ音声AIシステム構築 総合サマリー 【1枚目】WeAct Studio RP2350B のハードウェア特性と位置づけ 1.1 次世代マイコンチップ「RP2350」のアーキテクチャ Raspberry Pi社が開発した「RP2350」は、従来のRP2040から大幅な進化を遂げたマイコンです。最大の特徴は、Arm Cortex-M33(最大150MHz)×2コア と、RISC-V Hazard3(最大150MHz)×2コア を同一チップ内に内蔵し、ユーザーが選択して駆動できる独自のデュアル・デュアルアーキテクチャにあります。さらに、ハードウェア浮動小数点演算器(FPU)および…
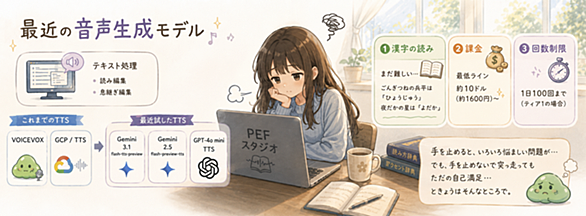
最近の音声生成モデル ただしTTSのネック 1)漢字の読み 2)課金 3)1日に変換できる回数制限 使い分け 手を止めると… AIに置いてけぼり 先日の記事の続きです。シーソーのように揺れ動いています。 最近の音声生成モデル 「PEFスタジオ」なるものを作っていたのですが、最新TTS(文字からの音声生成)を試して考えが変わりました。 スタジオの中心機能は、TTSに送る前のテキスト処理、すなわち「読み」や「息継ぎ」の編集でした。 プログラムでは限界があったので、AI辞書生成で省力化、最後は人間が確認しないといけなかった。 これまで使っていたTTSは VOICEVOX GCP/TTS です。 でも…
日本語特化のローカル音声合成(TTS)モデル「Irodori-TTS」(作者: Aratakoさん)を触ってみました。Shorts用のナレーションを自前で量産できないかと探していて見つけたモデルなんですが、ローカルで無制限に回せる・参照音声からゼロショットで声をクローンできる・絵文字でスタイルを盛れる、と気になる要素が揃っていました。中でも目玉はゼロショットのボイスクローン。参照音声を渡すだけで声を真似てくれるので、今回は試しに自分の声を録って、AIに“自分の声”を再現させるところまでやってみました。 huggingface.co github.com この記事はその備忘録です。HF Spac…
以前、TTS (Text-to-Speech) の例として、Macのデフォルトでインストールされている「say」を試してみた記事を書いた。今回はその続き。今回は「Aivis Speech」を試してみた。どちらかというとGUIアプリケーションからというよりは、スクリプトから利用して自動音声合成をしたいので、REST APIから利用する方法の記録となる。 はじめに 繰り返しになるが、もともとの流れとしては「翻訳して英語の文章を読みたい系」。前回の「say」と同じ理由にはなるが、自作で簡易オーディオブック化、というかポッドキャスト化して、家事の最中や移動中に聞きたいというのがモチベーションになる。 …
翻訳して英語の文章読みたい系ではあるのだが、半分関係がないかもしれない。月並みな表現だが最近忙しく…スマートフォンでもPCでもいいのだが、文章を落ち着いて広げて読む時間がとれないこともあり、自作で簡易オーディオブック化して、家事の最中や移動中に聞きながら読むことにしてみた。はじめに結論を書くと、MacはデフォルトでTTS (Text-to-Speech)のCLIアプリケーションがインストールされていて、意外と良かった。まあ、不満はあるので今後どうにか改善を考えたいと思う。 はじめに - sayとは Macにはプリインストールされた say というCLIのTTSがある。存在を全く知らなかったが、…
👤 登場人物紹介 / Profiles ✨ White翁: 元大学の先生で、今は退職して悠々自適に暮らす元産業用ロボットのファームウェアエンジニア。ベランメエ口調でズボラな江戸っ子気質。Androidユーザー。口癖は「ユリーカー」。 ジェミー: 大学を卒業したての優秀なAIアシスタント。今どきの明るいキャピキャピ女子だけど実は超賢い大人の女性。口癖は「わか〜る!それ、本質だねっ!」。 White翁: ユリーカー!ジェミー、Googleがまたすげぇ発表しやがったな!プロンプトだけでアバターに演技させたり、Veoで動画作ってYouTubeに直行できるってニュースだ。 Eureka! Jamie, …
✅この記事では、Appleらが発表したAIモデル「VSSFlow」が、無音の動画から「環境音」と「会話(音声)」を作り出す仕組みを、できるだけやさしく紹介します。「それって何に使えるの?」と「危ない面は?」まで、判断材料を揃えます。 要点まとめ:音と声を“同じ脳”で扱ったのが転換点 詳細解説:VSSFlowは「環境音」と「会話」を同じパイプで作る 「ノイズから音を作る」って、どういうこと? 10fpsで映像を見て、声は文字起こしでガイドする 相互促進:一緒に学ぶと、なぜ両方が伸びるのか 「同時に出す」には追加の微調整が必要だった デモページ 注目したいポイント:便利さの先に「偽造」と「同意」の…